prompt/中文版
2D GROUNDING · PROMPT v2 · 当前生产版本

跑批时每一步发的什么、看到的什么
以及哪些步骤在空转

先物体、后部件。每条给用途、中文原文、这一步到底发了几张图、分别是哪张;末尾单列一份「跑了但没起作用」的清单。 原文来自 dataengine/prompt_text.py 与 dataengine/prompts/。

00实际路径

跑批时真实发生的事

下面就是 run.py 实际执行的顺序。标「跳过」的是结构上不走的。

物体管线 · --mode object

R1.5 + GroundingPI + SAM3
  1. ① caption — 原图 → 5–7 条区域描述
  2. ② locate — GroundingPI 按 label 出框
  3. ③ 建池 — SAM3 按 caption 概念建 mask 池
  4. ④ 框→mask + pool refine
  5. ⑤ 验区 — mask 是不是这条 label
  6. ⑥ pick_better — 初始 / 精修 二选一
  7. ⑦ 五类出题 — 实体/空间/关系/可供性/物理
  8. ⑧ 验题 — 复用 ⑤ 的提示词
  9. ⑨ export

部件管线 · --mode part

27B + SAM3 · 无定位
  1. ① 部件 caption — 原图 → 「物体+部件」短语
  2. ② 归一化 + 黑名单
  3. ③ SAM3 文本切 — 短语 → mask
  4. ④ part verify — 只问是不是这个部件
  5. ⑤ PARTS 出题 — 抓取 / 功能 / 空间
  6. ⑥ export
00b空转清单

哪些东西在跑,但其实没起作用

不是 bug,是「代码里有、当前配置下不生效」,或者「写了但不解决问题」。列出来,下次别再指望它们。

项类型为什么不起作用证据 / 影响
--locator-fallback 空转 默认 off:GroundingPI 返回空框时不回退到 VLM 必须显式传 --locator-fallback vlm
PART_VERIFICATION_PROMPT(问归属那版) 死代码 --mode part 用的是 PART_ONLY_VERIFICATION_PROMPT(不问归属);带归属那版只被旧的 --part-mode 混合模式调用 两版并存,容易误以为归属检查还在
物体 caption 里的「部件」规则 近乎空转 允许写 <part> of <parent>,但 5–7 行预算被物体占满,模型基本不写 100 图实测:288 个 accepted region 里,真正的部件区域 0 个
部件 caption 的「8–14 行 / 至少 6 个」 负作用 图里只有 2 个部件时逼模型凑数 580 条部件行里 212 条被自己的黑名单挡回(37%)
红色蒙版填充(出题阶段的输入) 污染源 65% 不透明红把物体原色盖住,模型据此写出 Grasp the red handle 物体管线 4.8% 的题提到「红/高亮」;验区 89% 的拒绝理由提到红蒙版
处理状态:前两条是配置 / 死代码,不影响数据;后三条是真问题—— 第 3 条(caption 不写部件)无解但无害;第 4 条已加黑名单缓解;第 5 条还没改渲染,只加了提示词说明。
01总览

管线与 prompt 的对应关系

一条管线里每一步都要向模型问一次;问法决定了这一步能拿到什么。

物体管线

R1.5 + GroundingPI + SAM3
  1. ① 看图说话 — 区域级稠密描述
  2. ② 验区 — mask 是否正确
  3. ③ 五类出题 — 实体 / 空间 / 关系 / 可供性 / 物理
  4. ④ 验题 — 复用 ② 的判断逻辑

部件管线

27B + SAM3 · 无定位
  1. ① 部件描述 — 直接输出可分割短语
  2. ② 部件验区 — 只问是不是这个部件
  3. ③ PARTS 出题 — 抓取 / 功能 / 空间
关键差别:物体管线多一步「定位」,所以它的描述要输出能被框住的整物体; 部件管线没有框,描述必须直接输出能当 SAM3 文本提示的短语。
02物体管线

物体管线的 4 个 prompt

核心思路:先挑「值得被指代的区域」,再验证、再出题。4 步里 3 步送 2 张(②③④),只有 ① 送 1 张。

①

看图说话

REGION_DENSE_CAPTION_META_PROMPT

干什么:让模型先推理、再输出 5–7 个高价值且互不重复的区域。

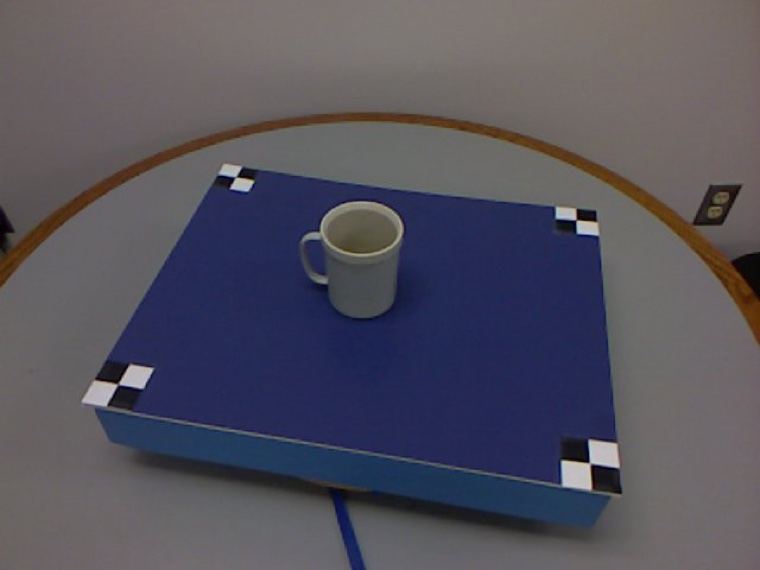
输入 1 张 ① 原图
模型看到的输入:一张原图
①原图(长边缩到 768)
这一步只送一张图:没有框、没有 mask、没有任何叠加。caption、验区、出题、验题全部基于这个尺寸的原图。

系统元提示:区域级稠密描述(绝对指代)

任务

给定一张图,挑出 5–7 个高价值、互不重复的区域,用自然对话的方式给它们打标签。

阶段一 —— 先推理

在 <reasoning> 里简要回答:

  • 场景类型(人像 / 室内 / 室外 / 产品图等)
  • 5–7 个最显著的物体或区域
  • 空间布局(前景 / 中景 / 背景)
  • 对候选区域评估:可指代性、能构成关系的潜力、是否需要消歧、分割是否清晰
  • 选择结果:选了哪 5–7 个、为什么、能支撑什么提问

阶段二 —— 再输出

在 <output> 里列出 5–7 行,严格格式:

  • 索引 0..N-1,连续
  • 一行一个:[<索引>: <标签>]
  • 标签 = 基础类别 + 区分性属性 + 粗略位置 + 空间关系
  • 每个标签 ≤15 词;绝对化表达,自成一体(不用代词、不用指代)

标注规则

  • 基础类别:常用名词(人、椅子、笔记本、窗、树、车、墙、地板、天空等)
  • 属性:颜色 / 材质 / 状态 / 图案 / 透明度,有帮助时才写
  • 位置:九宫格 + 前景 / 中景 / 背景
  • 关系:在…上面 / 下面 / 旁边 / 后面 / 前面 / 里面 / 紧挨着 <类别>
  • 用词一致;除刻意合并同类外一律用单数
  • 部件:写成「<部件> of <父物体类别>」,父物体必须在前文出现过
  • 允许 stuff 区域(天空、墙、地板、道路、草地、水面),前提是显著
  • 优先清晰、大于 50×50 像素、边界明确的区域;跳过小于 24×24 的杂物、重叠超过 80%、模糊块
  • 质量优先于数量;简单场景里少几个也可以
  • 不要编造物体,不要写置信度

选择策略

  • 覆盖主体对象和可交互物体
  • 保证空间与语义上的多样性
  • 选出来的区域要能支撑它们之间的自然关系
  • 只有当一组东西被当作一个整体指代时才合并(例如双显示器)

最终回答格式

<reasoning> [简要分析与选择理由] </reasoning> <output> [0: 区域描述] [1: 区域描述] ... </output>

示例

<reasoning> 室内工作台;显著的:人(前景)、笔记本、杯子、木桌、窗(背景)。 选它们因为可指代、彼此有关系(在桌上、在人后面)。 </reasoning> <output> [0: 人, 蓝色衬衫, 中央前景] [1: 笔记本, 银色, 在桌上] [2: 杯子, 白色陶瓷, 桌子右侧] [3: 桌子, 木质表面, 中景] [4: 窗, 玻璃, 人后方的背景] </output>
为什么允许 stuff:墙、地板、桌面这些也是合法的指代对象("把桌上的东西拿起来")。 代价是 100 图里会切出大量大面积背景区域,也是低 IoU 样本的主要来源。
②

验区

SEG_PROMPT_VERIFICATION_PROMPT

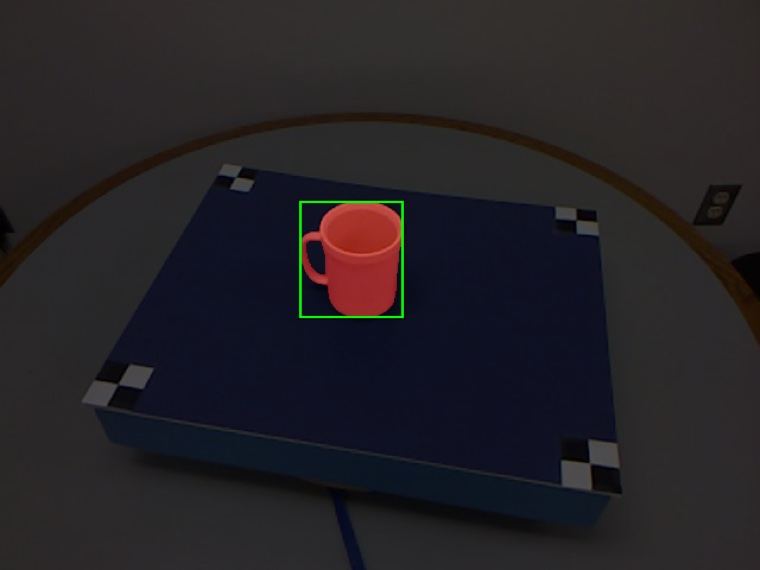
干什么:一次发两张图(① 框、无 mask / ② 框 + mask)加一句指代表达,判断这个 mask 是不是这句话说的东西。
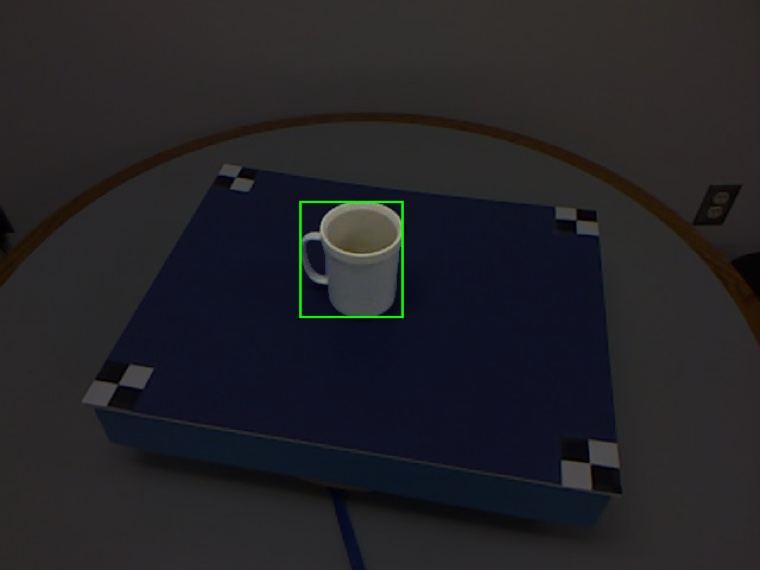
输入 2 张 ① 框(无 mask)→② 框 + mask 高亮 两张一起送进模型
模型第 1 张输入:绿框、无 mask 填充
①框(无 mask):绿框标范围、区域外压暗,杯子本身一点没涂
→
模型第 2 张输入:框 + mask 红色高亮
②框 + mask 高亮:同一张图把 mask 涂成 45% 红
模型对比「有没有涂色」来判断这块区域对不对:两张图除了「杯子被涂红」这一处,其余完全相同。 第 1 张不是原图——它已经带了绿框和压暗,只是没有 mask 填充,这正是它和部件验区(第 1 张纯原图)不同的地方。

你在验证一个 mask 是否正确地标识了图像中某个指代表达所描述的对象。

你的任务

给定一张图、一个指代表达,以及可选的 mask(用框标出),判断这个 mask 是否正确。

规则

如果给了 mask:以下三条全部满足才接受。

  1. mask 区域对应该表达所描述的目标。
  2. mask 没有包含该表达之外的东西。mask 应覆盖最显著、最主要的匹配实例——如果图中还有别的未标出的匹配区域,只要 mask 包含了最明显的那几个,就接受。
  3. 这个表达是图中某个东西的合理说法。

如果没给 mask:只有当图中确实没有任何东西匹配该表达时才接受。

重要

对自然的指代表达要宽容。人们会用各种方式描述事物。重点看 mask 是否匹配描述,而不是描述本身是否完美。

输出

{"accept": true 或 false, "reason": "简要说明"}
「要宽容」这句很关键:它直接决定区域接受率。太严会把正确区域拒掉,太松会把假阳性放进来。 100 图上这条的接受率是 64.5%。
③

五类出题

ENTITIES / SPATIAL / RELATIONS / AFFORDANCES / PHYSICS

干什么:对每个合格区域,按 5 个概念维度各问一次。五个模板骨架几乎一样,只有主题不同。
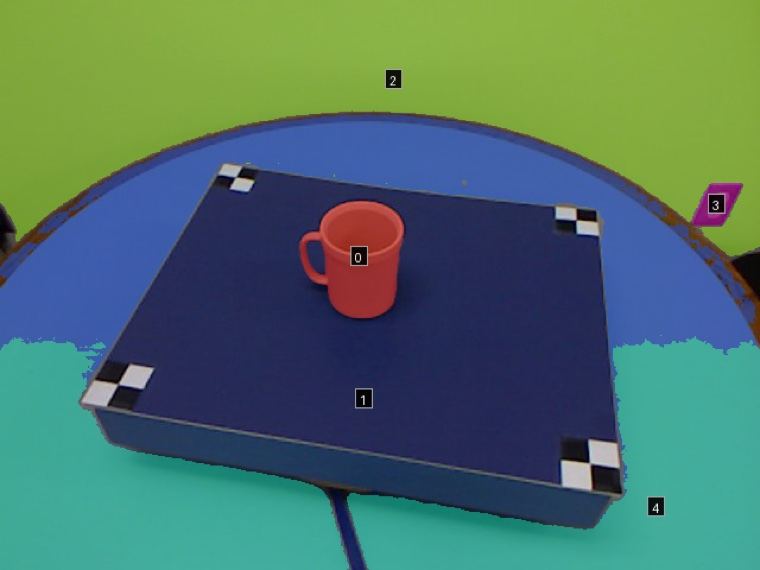
输入 2 张 ① 原图→② 全区域编号叠加 两张一起送进模型
模型第 1 张输入:原图
①原图:读颜色、材质、纹理只能看这张
→
模型第 2 张输入:所有区域彩色涂色并编号
②所有区域编号叠加(all_regions_colored.png):每个区域一种颜色 + 0..N 编号
模型要在一张图上比较哪些区域满足同一条件:原图给它看真实观感,编号叠加图给它看候选集合和编号。 两图缺一不可——只有叠加图会把涂色当成物体颜色,只有原图则没有编号可引用。

共用骨架

你是一个专家级 AI,任务是生成有难度、抽象的分割题。

你会拿到:一张图、同一张图的 mask 叠加编号版、以及一份稠密描述(可用 mask 的编号列表)。

任务

设计最多 3 条有挑战性的分割题。每条都必须靠视觉检查,把某一部分区域从其它区域里区分出来。

核心原则:上下文合理性规则(最重要)

题目必须对整个画面场景都成立,不能只对那几个 mask 成立。

生成的题只能适用于目标 mask 区域,不能适用于图中任何未标出的区域。

  • 要避免的问题:出的题在未标出区域里有更好的答案。
  • 反例:图里有桌子(未标出)和椅子(已标出)。出"分割一个可以放饮料的表面"却返回椅子 → 无效。
  • 正例:同样的场景,椅子是木的、桌子是金属的,出"分割木质家具" → 有效。

硬约束一:抽象、非平凡

题目必须需要视觉辨别多个候选区域,不能只读描述就能答。

  • 有效:"分割戴帽子的人"(要逐个检查)
  • 无效:"分割那辆车"(只有一辆车时就是查表)
  • 检验标准:用户是否必须视觉比较多个区域才能找到答案?

硬约束二:真子集规则

  • candidates:从描述里挑出的、用户可能会考虑的候选区域
  • satisfying:视觉检查后真正满足题目条件的区域
  • satisfying 必须是 candidates 的真子集(不能完全相同)。空集合法。

硬约束三:格式

  • 题目:最多 10 个词,以动作动词开头("Segment…"、"Identify…")
  • 概念族:从下面列表里选最多 3 个
  • 只输出 JSON,不要解释、不要 markdown 围栏
模板题目要考察什么额外强调
实体 ENTITIES实例、类别、群体、异常个体按视觉属性(材质、部件、状态、纹理、成组)分组,而不是模糊的功能暗示
空间 SPATIAL排布、位置、包含、远近最高级说法(最近、最大、最左)必须限制在已标出的集合内,例如"最左边的杯子",不能说"最近的物体"
关系 RELATIONS动作、状态、事件中的角色锚定在可视觉验证的交互与状态上,避免高层意图被未标出的物体推翻
可供性 AFFORDANCES功能属性、可用性、潜在用途找唯一适用于该 mask 的功能条件,避免和未标出的更合适物体冲突
物理 PHYSICS稳定性、容纳、危险、物理属性只对可验证的物理状态(不稳、会洒、锋利)出题,不做被推翻的全局断言
v2 新增(在请求里,不在模板里):每次出题都会拼上一句
“第二张图上的彩色蒙版是标注,不是物体的颜色;颜色、材质、纹理请从第一张未标注原图读取。”
改的是 prompt_backends.py 的 concept_prompts(),一处覆盖 5 类 + PARTS。尚未跑批验证。
实测效果:466 个合格区域 → 1491 条题,平均每区域 3.2 道。 这是五类分开问的直接结果;只问一次就只有 0.47 道(部件管线就是这样)。
④

验题

复用 ② 的提示词

干什么:一题一验。它直接复用 ② 的验区提示词,只是把两张图换成「原图 + 单题高亮图」、把指代表达换成题目文本。
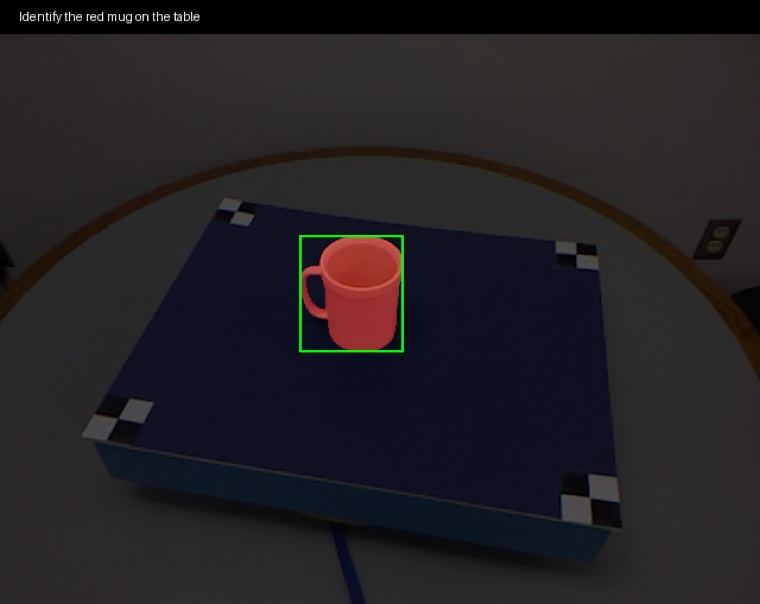
输入 2 张 ① 原图→② 单题高亮 两张一起送进模型
模型第 1 张输入:原图
①原图:判断「这块地方本身是什么」
→
模型第 2 张输入:只高亮这道题指向的区域,顶部带题目原文
②单题高亮(generated_prompts_viz/NN_prompt.png):只涂这道题指向的区域,顶部印题目原文
只高亮这道题指向的那一块,判断「只看这块能不能回答」:原图用来确认这块在整张图里到底是什么,高亮图用来确认答案是否只落在这一块上。

判断逻辑完全一样:这个被高亮的区域,能不能回答这道题。答不出来就是废题。

100 图上:1491 条题 → 961 条通过(64.5%)→ 导出 827 行。
03部件管线

部件管线的 3 个 prompt

核心思路:描述直接产出能喂 SAM3 的短语;验区只问「是不是这个部件」。3 步里 2 步送 2 张(②③),只有 ① 送 1 张。

①

部件描述

PART_ONLY_CAPTION_META_PROMPT

干什么:不列物体清单,直接输出「物体+部件」的短语,每行一条。

输入 1 张 ① 原图
模型看到的输入:一张原图
①原图(长边缩到 768)
这一步也只送一张图。注意:部件管线的 caption 只看到图,看不到物体列表——所以它必须把物体名写进短语里。

你负责列出机器人操作所需的功能性部件。看图,只报告机械手可以抓、握、按、拉、转的物理子部件。

输出格式(严格)

<物体> <部件>, <属性>, <位置>

好的例子

mug handle, curved, right side bottle cap, ridged, top spatula blade, steel, front drawer handle, metal, lower left robot arm end effector, black, center pan lid, glass, center

禁止输出

mug ← 整个物体,没有部件 mug, white ceramic ← 没有部件名 handle, curved ← 部件但没带物体名 table surface, wooden ← 表面,不是部件 person hand, skin ← 人体部位 background, white ← 不是物体的部件

规则

  1. 图里部件足够时输出 8–14 行。只要图里有可抓物体,争取至少 6 个部件;回答前先数行数。不要凑数、不要重复——只有 3 个真实部件就输出 3 行。
  2. 短语的最后一个词是部件名,前面的词是拥有它的物体。写「mug handle」,永远不要只写「handle」。
  3. 部件名必须功能性、可抓取:handle、grip、cap、lid、cover、blade、spout、knob、dial、button、switch、rim、trigger、latch、lever、crank、wheel、clip、tab、hook、nozzle、valve、plug、strap、buckle、hinge、pedal、joystick、end effector、lens、drawer、key。
  4. 绝不要列:整个物体、人或人体部位、桌子、墙、地板、天花板、表面、内部、图案、logo、文字、阴影、反光、边缘、轮廓、背景。
  5. 4b(v2 新增):绝不要列机器人自己的身体 —— robot arm、end effector、gripper、wrist、flange、joint、link、base、camera mount。这些是执行动作的机器,不是被操作的对象。
  6. 属性 = 一个简短的材质、颜色或形状词;位置 = 左 / 右 / 中 / 上 / 下 / 前 / 后,可带锚点("桌子右侧")。
  7. 不要编号、不要括号、不要项目符号、不要 markdown、不要 JSON、不要评论。

最后一条

每一行都会被原样当作分割文本提示使用,所以它必须读起来像一个短的英文名词短语。

两个设计要点:
① 物体名写进短语,不需要父物体索引,parent_missing 从 15 条降到 0
② 格式直接可喂 SAM3,不需要"长句转短语"的二次处理
已知副作用:「至少 6 个」是硬指标,图里只有 2 个部件时模型会凑数。 实测 580 条部件行里 212 条被自己的黑名单挡掉,相当于 37% 是无效产出。
②

部件验区

PART_ONLY_VERIFICATION_PROMPT

干什么:红色高亮是候选 mask,只判断它是不是那个部件。

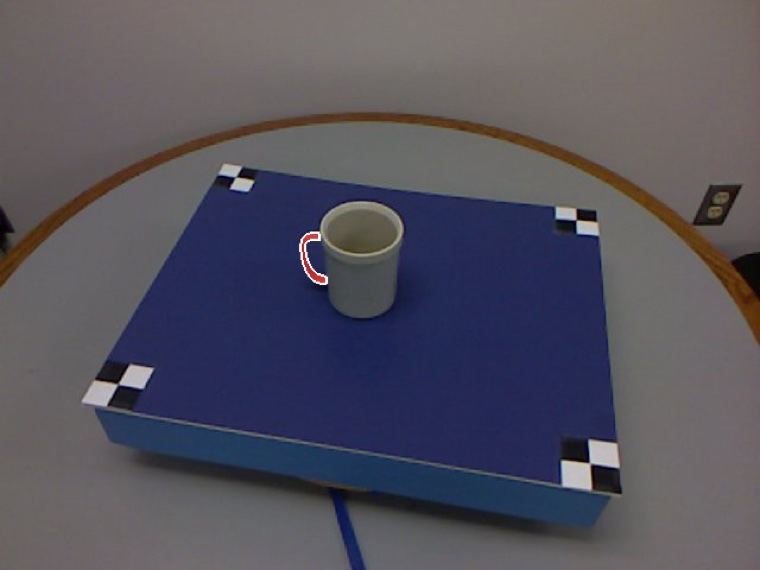
输入 2 张 ① 原图→② 红色高亮 两张一起送进模型
模型第 1 张输入:原图
①原图:这块红的大致在什么部位
→
模型第 2 张输入:候选部件红色填充 + 白描边
②红色高亮(_part_highlight):65% 红填充 + 2px 白描边
只问「这块红的是不是那个部件」,不问它属于哪个物体。原图负责交代上下文,红图负责圈出候选区域—— 白描边是为了在父物体本身是红色时仍能看清边界。

你在验证一个用于机器人操作的部件级分割。红色高亮是待验证区域,图中其它部分不高亮。

两个问题

Q1:高亮覆盖的是「{部件}」本身,而不是整个物体或它的一大部分?

Q2:高亮是否紧贴这个部件,没有吞掉周围大部分物体?

接受条件

只有当高亮像素就是那个被点名的部件时才接受:不是整个物体,也不是周围物体的大部分。

禁止事项

不要判断归属,不要问这个部件属于哪个物体。只回答高亮区域是不是那个被点名的部件。

输出

{"is_part": true 或 false, "reason": "简短"}
为什么明确禁止判归属:27B 之前会自己判("抽屉的 owner 是柜子"), 在 129 条拒绝里有 32 条属于这种越界判断,白白丢掉可用部件。 独立管线本来也没有父物体索引,归属问题不该问。
③

PARTS 出题

PARTS_META_PROMPT

干什么:一次发两张图(原图 + 全部件叠加图)加一份部件描述,出最多 3 条题。

输入 2 张 ① 原图→② 全部件叠加 两张一起送进模型
模型第 1 张输入:原图
①原图:部件的真实颜色和形状
→
模型第 2 张输入:所有部件涂色叠加
②全部件叠加(all_parts_colored.png):每个部件一种色相
模型对着全部件的叠加图挑一个出题,再判定还有哪些候选也满足。它必须同时点明父物体、部件、动作,三者缺一就不是部件级题。
渲染现状(对答案很关键):叠加图里每个部件是不同色相的填充(overlay_multi 按黄金比例取色:红 / 蓝 / 紫…), 而且部件这张 all_parts_colored.png 没有画 0..N 的编号标签——编号只出现在物体侧的 all_regions_colored.png 上。 于是模型只能靠「这块被涂成什么颜色」来指代:这既是题目写成「红色的把手」的直接来源, 也是「把整条手臂当一个部件」的诱因之一(整条手臂被涂成一整块,看不出内部还有子部件)。 (v2 已在请求里加了「彩色是标注,不是颜色」的说明,但渲染本身还没改。)

你是一个专家级 AI,任务是针对物体的功能性部件生成分割题。

你会拿到一张图,以及同一张图上叠加并编号了已接受部件 mask 的副本。下方的稠密描述只列出部件区域(例如「mug handle」「bottle cap」)。

任务

设计最多 3 条分割题,题目必须要求观察某个部件及其父物体。目标必须恰好是某一个高亮的部件区域。

指导原则:部件、父物体、动作

每条题都必须同时点明父物体和部件,以及这个部件支持的动作。一条能被整个物体回答、而不是被部件回答的题是无效的。

题目必须只适用于被高亮的部件,而不适用于图中任何其它未标出的区域。

  • 抓取 GRASP —— 这个部件怎么被握住:「抓住杯子的把手」
  • 功能 FUNCTION —— 这个部件是干什么的:「按下瓶子的盖子」
  • 空间 SPATIAL —— 部件在父物体的哪个位置:「把手在杯子的哪一侧」

动词必须匹配部件类型

从部件本身选动词,不要套模板。对一个抓不住的部件用「抓」是错误,哪怕句子读起来很顺。

部件该用的动词
handle, grip, lever, strap, tab, drawer抓 / 拉(grasp / pull)
button, switch, pedal, key按 / 推(press / push)
cap, lid, knob, dial, valve, crank转 / 开 / 关(turn / open / close)
blade, blade edge切(cut)
spout, nozzle倒(pour)
rim, edge, outline通常不可操作,跳过
end effector, gripper, robot arm, wrist永远不用「抓」——这是机器人自己的执行机构,不是操作目标。跳过,或改问接触 / 功能

对照

反例: "抓取机器人手臂的末端执行器" (机器人抓不住自己的手) 反例: "抓取面板的按钮" (应该是「按」) 正例: "按下面板的按钮" 正例: "旋转瓶子的盖子" 正例: "机器人手臂的哪一部分负责接触?"

硬约束一:部件级,不是物体级

  • 反例:「分割杯子」(这是父物体,不是部件)
  • 正例:「分割杯子的把手」

硬约束二:真子集规则

  • candidates:描述里用户可能考虑到的部件区域
  • satisfying:视觉检查后真正符合题目的候选
  • satisfying 必须是 candidates 的真子集

硬约束三:格式

  • 题目:最多 12 个词,属于上面三种类型之一
  • concept_family 设为 parts,sub_concept 设为 grasp / function / spatial
  • 只输出 JSON,不要解释、不要 markdown 围栏
为什么加动词规则:实测 176 条题里有 5 条涉及机器人自身部件, 其中 4 条是「抓取机器人手臂的末端执行器」——语义颠倒。 这条规则是在跑完 100 图之后补的,还没在新跑批里验证。
04构造差异

两份描述 prompt 的结构差异

这是两条管线唯一「从根本上不同」的地方,其余 prompt 只是上下游关系。

维度物体描述部件描述
输出行数5–78–14(争取 ≥6)
编号有 [0: …]没有
单位一个物体 / 一块区域一个「物体 + 部件」短语
物体名作为基础类别写在最前嵌进短语(mug handle)
推理阶段有(先写 reasoning)没有,直接输出
Stuff 区域允许(墙 / 地板 / 天空)禁止
人体允许 person禁止(人体部位也不算)
后续步骤喂 GroundingPI 出框直接喂 SAM3
一句话:物体描述产出的是「可被指代的区域」,部件描述产出的是「可直接分割的短语」。 前者要经过框这一层,后者不需要。
05取舍

五个设计取舍,以及它们的代价

设计为了什么代价 / 实测
物体描述允许 stuff墙、桌面、地板也是合法指代对象切出大量大面积背景;低 IoU 样本几乎都是 stuff
验区提示词「要宽容」避免把正确区域误拒接受率 64.5%,但也放进了一些边界模糊的 mask
五类分开问每类问法不同,能问出不同类型的题每区域 3.2 道题,调用量占全流程 15%
部件描述不带编号不依赖父物体索引,parent_missing 归零无法表达「左边那个杯子的把手」这类消歧
部件验区不问归属避免模型越界判断,救回 32 个部件如果描述把部件挂错物体,验区发现不了
还没解决的两件事:
① 部件描述的「至少 6 个」导致 37% 的产出被自己的黑名单挡回
② 部件只出 1 类题,所以 172 个部件只换来 95 行;物体那边 466 个区域换来 827 行